FPGA Üzerinde Uçta Yapay Zeka: Donanım Seçimi ve Dağıtım Stratejileri
FPGA Üzerinde Uçta Yapay Zeka: Donanım Seçimi ve Dağıtım Stratejileri
Bir modeli bulutta yüksek doğrulukla eğitmek işin kolay kısmıdır. Zor kısım, aynı modeli 5 watt’ın altında ve 10 milisaniyenin altında bir gecikmeyle uç cihazda çalıştırmaktır.
Standart 32-bit kayan noktalı (FP32) modeller yapıları gereği açgözlüdür: yüksek bellek bant genişliği ve yoğun hesaplama isterler; bu da onları pille çalışan çoğu uç donanım için kullanışsız kılar. Oysa yapay zekayı buluttan uca taşımak artık bir tercih değil. Veri gizliliği, çevrimdışı çalışabilirlik ve ultra düşük gecikme gerektiren sistemlerde yapısal bir zorunluluktur.
Bu noktada donanım seçimi, sistemin uygulanabilir olup olmadığını belirleyen en kritik karardır. Uç GPU’lar ve TPU’lar yaygın olsa da; deterministik gecikme, özelleştirilebilir veri yolları ve watt başına en iyi performans gerektiren uygulamalarda FPGA güçlü bir alternatiftir. Ancak bir yapay zeka modelini FPGA’ye entegre etmek, donanım kaynak kısıtlarının sistematik biçimde yönetilmesini gerektirir.
Bu yazıda uç çıkarım (edge inference) için FPGA’nin mimari avantajlarını, kaynak kısıtlarının doğasındaki zorlukları ve RunX olarak bu darboğazlara donanıma-duyarlı kuantizasyon ve donanım-yazılım ortak tasarımıyla nasıl yaklaştığımızı ele alıyoruz.
1. Uçta Yapay Zeka Sistem Gereksinimleri
Endüstriyel otomasyon, otonom robotik ve yüksek hızlı bilgisayarlı görüde bulut tabanlı çıkarıma güvenmek, gerçek zamanlı kontrol döngülerini bozabilecek gecikme dalgalanmalarına (jitter) yol açar. Yüksek çözünürlüklü kareleri sadece birkaç uzamsal koordinat elde etmek için ağ üzerinden buluta göndermek, zaman-kritik sistemler için baştan verimsizdir.
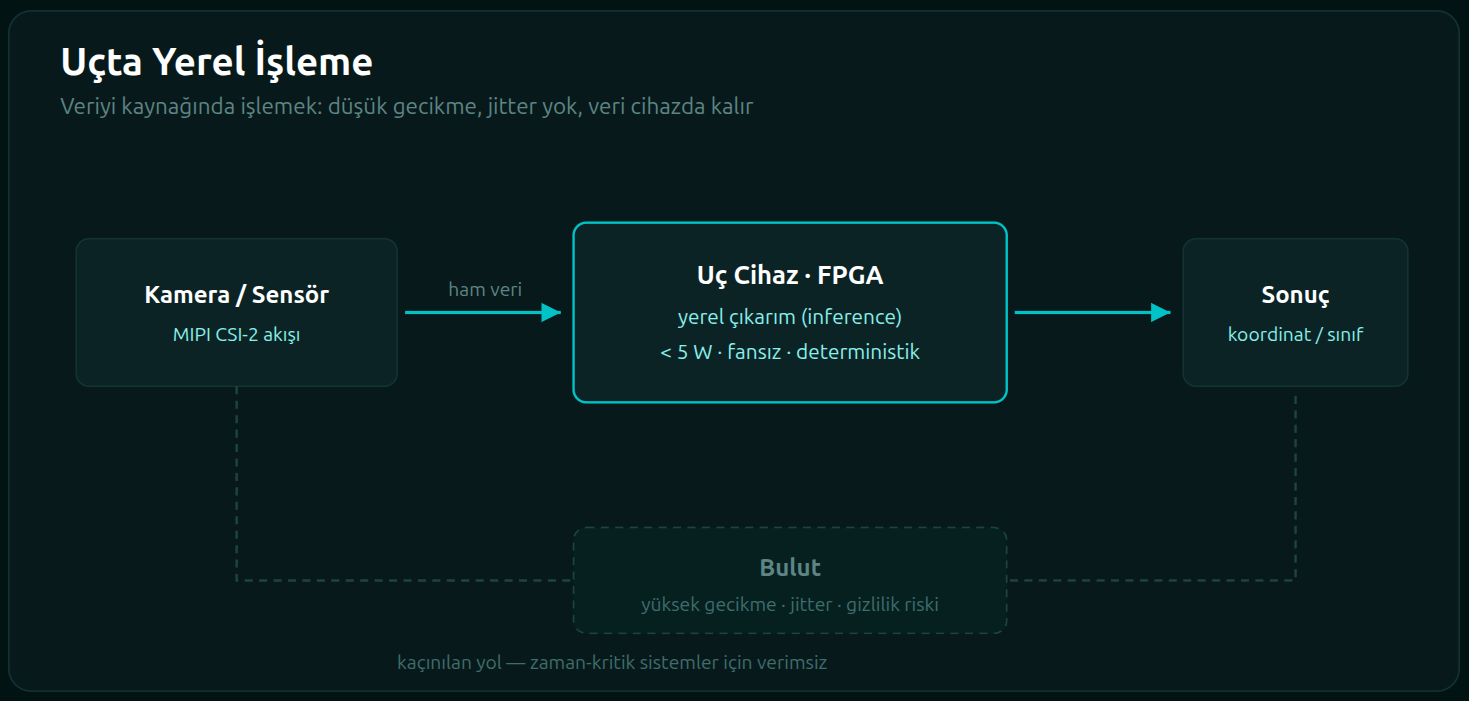
Uçta yapay zeka, işlemeyi yerelleştirerek bu sorunu ortadan kaldırır. Ama uç donanım katı fiziksel sınırlar altında çalışır: kısıtlı termal yayılım (çoğu zaman fansız tasarım zorunluluğu) ve dar güç zarfları (sıklıkla 5 watt’ın altında). İşlem birimi, MIPI CSI-2 kamera akışı gibi ham sensör verisini alıp sinir ağı çıkarımını tek ve yüksek hızlı bir boru hattında yürütebilmelidir.
Standart mikrodenetleyiciler bu paralel işleme yükünü kaldıramaz. Genel amaçlı uç GPU’lar ise deterministik gecikmeyi korumakta zorlanır ve bir işletim sistemini beslemek için hatırı sayılır güç harcar. FPGA tam da bu kısıtları hedef alarak tasarlanmıştır.
2. FPGA’nin Mimari Avantajları
FPGA, sinir ağlarını uçta çalıştırmak için dört temel avantaj sağlar:
- Deterministik gecikme: Dinamik iş parçacığı planlaması ve karmaşık bellek hiyerarşilerine dayanan GPU’ların aksine, FPGA deterministik donanım boru hatları kurmanıza izin verir. İşleme, kesin ve öngörülebilir saat döngülerinde gerçekleşir. Yüksek hızlı senkronizasyon gerektiren görevler için olmazsa olmaz.
- Özelleştirilebilir veri yolları: Geleneksel işlemciler veriyi önceden tanımlı 32/16/8-bit ALU’lardan geçirir. FPGA ise veri yolunu modelin tam gerektirdiği bit genişliğinde sentezlemenize izin verir. Bir ağ 4-bit ağırlık ve 5-bit aktivasyonla en iyi çalışıyorsa, donanım tam o boyutlara uyarlanır ve silikon israfı ortadan kalkar.
- Doğrudan sensör veri alımı: Yüksek bant genişlikli arayüzler doğrudan FPGA dokusunda sonlandırılabilir. Renk uzayı dönüşümü gibi ön işlemler donanım mantığında yapılır ve sonuç doğrudan hızlandırıcıya beslenir. Bu, harici DDR belleği baypas ederek hem gücü hem gecikmeyi belirgin biçimde düşürür.
- Donanım uyarlanabilirliği: Derin öğrenme hızlı değişir. ASIC üretildikten sonra sabittir; FPGA ise yeni ağ topolojilerini ve aktivasyon fonksiyonlarını desteklemek için sahada yeniden yapılandırılabilir.
3. Donanım Kaynak Kısıtı Problemi
Bu mimari uygunluğa rağmen, modern bir CNN’i bir FPGA’ye haritalamak (mapping) ciddi bir teknik karmaşıklık taşır.
PyTorch veya TensorFlow’da eğitilen modeller doğal olarak FP32 kullanır. Bir FPGA içinde FP32 çarpıcılar kurmak aşırı mantık kaynağı tüketir; milyonlarca FP32 parametreyi saklamak ise yüksek bellek kapasitesi ister.
Uç sınıfı FPGA’ler sınırlı çip içi bellek (BRAM/UltraRAM) ve sonlu sayıda DSP dilimiyle kısıtlıdır. Model parametreleri çip içi BRAM kapasitesini aştığı anda sistem sürekli harici DDR’den veri çekmek zorunda kalır. Bu bant genişliği sınırı ciddi bir darboğaz yaratır. Çünkü uçta veri hareketinin enerji maliyeti çoğu zaman hesaplamanın maliyetini aşar.
Sonuç net: uçta yapay zekayı bir FPGA’de etkili biçimde çalıştırmak, doğruluğu koruyan agresif model sıkıştırma teknikleri gerektirir.
4. Kaynak Optimizasyonu için Kuantizasyon
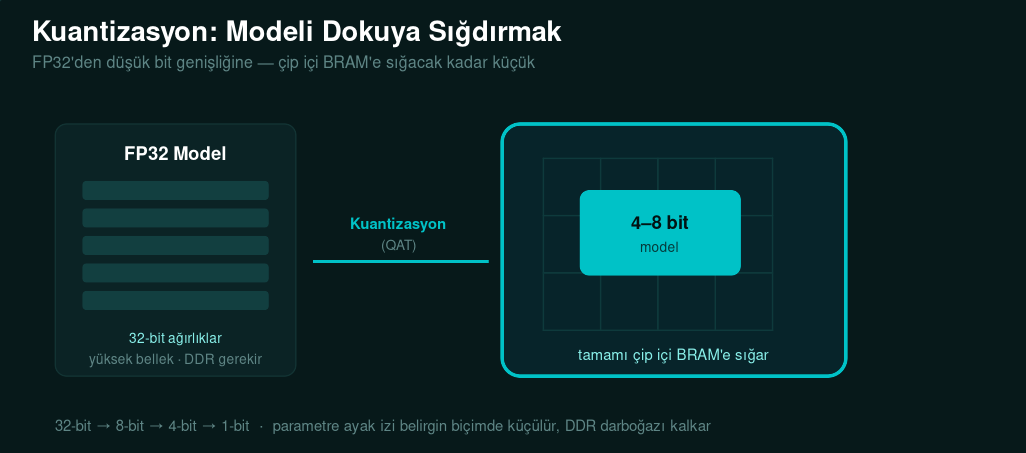
Yapısal model sıkıştırmanın temel tekniği kuantizasyondur: ağırlıkların ve aktivasyonların 32-bit kayan noktadan daha düşük bit genişlikli tam sayılara dönüştürülmesi.
İki ana yöntem var:
- Eğitim Sonrası Kuantizasyon (PTQ): Halihazırda eğitilmiş bir FP32 modelin hassasiyetini düşürür. Uygulaması ucuzdur, ama karmaşık mimarilere ya da çok düşük bit genişliklerine (ör. 4-bit) uygulandığında genellikle belirgin doğruluk kaybına yol açar.
- Kuantizasyon Farkındalıklı Eğitim (QAT): Düşük hassasiyeti eğitimin içinde simüle eder. Ağ, kuantizasyon gürültüsüne eğitim sırasında algoritmik olarak uyum sağladığı için, çok düşük bit genişliklerinde bile doğruluğunu korur.
FPGA mimarileri için optimum strateji QAT’tir. 4-bit, 2-bit ve hatta 1-bit (İkili Sinir Ağları BNN) hassasiyetini mümkün kılar. Parametre ayak izini en aza indirerek modelin tamamının FPGA’nin dahili BRAM’inde saklanmasına olanak tanır; böylece DDR darboğazı ortadan kalkar ve çıkarım verimi en üst düzeye çıkar.
5. Donanıma Duyarlı Kuantizasyon Yaklaşımı
Genel kuantizasyon çerçeveleri, hedef hızlandırıcının spesifik mikro mimari kısıtları için optimizasyonda çoğu zaman yetersiz kalır. Kritik olan, kuantizasyonu donanımdan bağımsız bir son-işlem adımı gibi değil, hedef FPGA’nin kaynak bütçesiyle birlikte tasarlamaktır.
RunX olarak bu alanda donanıma duyarlı bir QAT yaklaşımı uyguluyoruz: hedef FPGA’nin somut mantık, bellek ve DSP bütçesini eğitim döngüsüne girdi olarak veriyor, modeli katman bazında değişen bit genişliklerine (1-bit’ten 8-bit’e) sıkıştırıyoruz. Böylece standart bir CNN, güç açısından verimli ve o donanıma uyarlanmış bir modele dönüşüyor; kritik ağırlıklar çip içi BRAM’de tutulabildiği için DDR darboğazı ortadan kalkıyor.
Bu yaklaşım, karma hassasiyetli stratejilere olanak tanır: özellik çıkarma katmanları agresif biçimde (ör. 4-bit) kuantize edilirken, sınıflandırma gibi daha hassas katmanlar yüksek hassasiyette (ör. 8-bit) tutulabilir. Doğruluğu korurken kaynak tüketimini en aza indirmenin pratik yolu budur.
6. Dağıtım Mimarisi
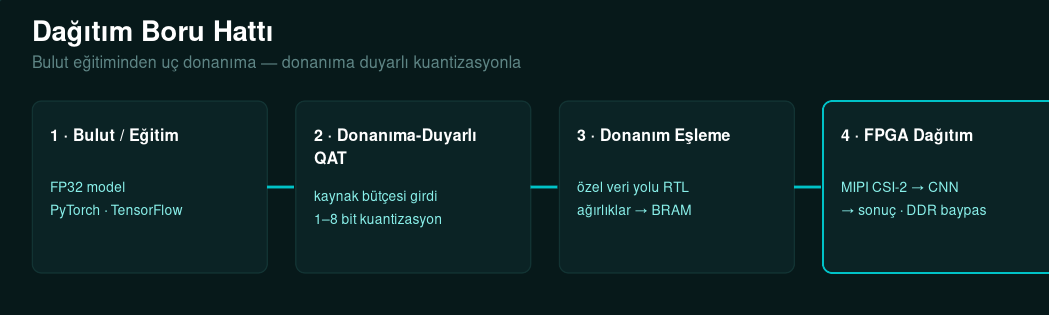
Modeli bulut eğitim ortamından uç donanıma taşıyan boru hattı dört aşamada işler:
- Bulut / Eğitim: FP32 model PyTorch/TensorFlow ile eğitilir.
- Donanıma-Duyarlı QAT: Hedef FPGA’nin mantık/BRAM/DSP bütçesi eğitim döngüsüne girer; model değişken bit genişliğinde (1–8 bit) kuantize edilir.
- Donanım Eşleme: Kuantize model, tam bit genişliğine sentezlenmiş özel veri yolu RTL’ine dönüşür; ağırlıklar çip içi BRAM’e yerleştirilir.
- FPGA Dağıtım: MIPI CSI-2 → donanımda ön işleme → CNN hızlandırıcı → sonuç; tüm akış çip içinde, DDR baypas edilerek yürür.
7. Sonuç
Yapay zeka modellerini FPGA üzerinde çalıştırmak, özünde bir donanım-yazılım ortak tasarımı sürecidir: RTL tasarımı, zamanlama kapanışı, bellek mimarisi optimizasyonu ve derin öğrenme matematiğinde birleşik uzmanlık ister.
RunX olarak sağlam uçta yapay zeka sistemleri için kendi IP çekirdeklerimizden, donanıma-duyarlı kuantizasyon yaklaşımlarımızdan ve geniş donanım mühendisliği deneyimimizden yararlanıyoruz. İster mevcut bir sinir ağını bir uç işlemci için optimize edin, ister sıfırdan özel bir FPGA mimarisi tasarlayın; sıkı performans ve verimlilik hedeflerini tutturmak için gereken teorik ve pratik temeli sağlıyoruz.
Gelecek projeleriniz için teknik gereksinimleri ve dağıtım stratejilerini konuşmak üzere mühendislik ekibimizle iletişime geçebilirsiniz.
Bize ulaşın: info@run-x.com | www.run-x.com